Das Start-up DiffuSpace aus Shenzhen hat in zwei Finanzierungsrunden knapp 500 Millionen Yuan eingesammelt, rund 67 Millionen Euro. Zu den Geldgebern zählen Huawei und der Fahrchip-Hersteller Horizon Robotics. Das Kapital fließt in Sprachmodelle, die einen Text nicht Wort für Wort aufbauen, sondern als Ganzes entwerfen und dann verfeinern.
 drweb.de als bevorzugte Quelle auf Google hinzufügenQualitätsgeprüfte Inhalte direkt in Google News & DiscoverJetzt hinzufügen
„Xiaoming fährt nach Guangzhou, um Char Siu zu essen“: An diesem Satz erklärt Mitgründerin Gong Shansan, worin sich ein Diffusions-Sprachmodell von ChatGPT und Co. unterscheidet. Das Modell von DiffuSpace setzt zuerst „Xiaoming“ und „Char Siu“ und füllt die Lücke dazwischen in mehreren Durchgängen auf, berichtet das Technologieportal TMTPost exklusiv.[1]
Das Wichtigste in Kürze
- DiffuSpace hat laut Investoren knapp 67 Millionen Euro eingesammelt, angeführt von Matrix Partners China.
- Huaweis Beteiligungsgesellschaft Hubble und Horizon Robotics investieren mit, im Training ist ein Modell mit 30 Milliarden Parametern.
- Diffusionsmodelle erzeugen mehrere Token gleichzeitig und sollen laut Anbieter in bestimmten Szenarien fünf- bis zehnmal schneller antworten.
Wie funktioniert ein Diffusions-Sprachmodell?
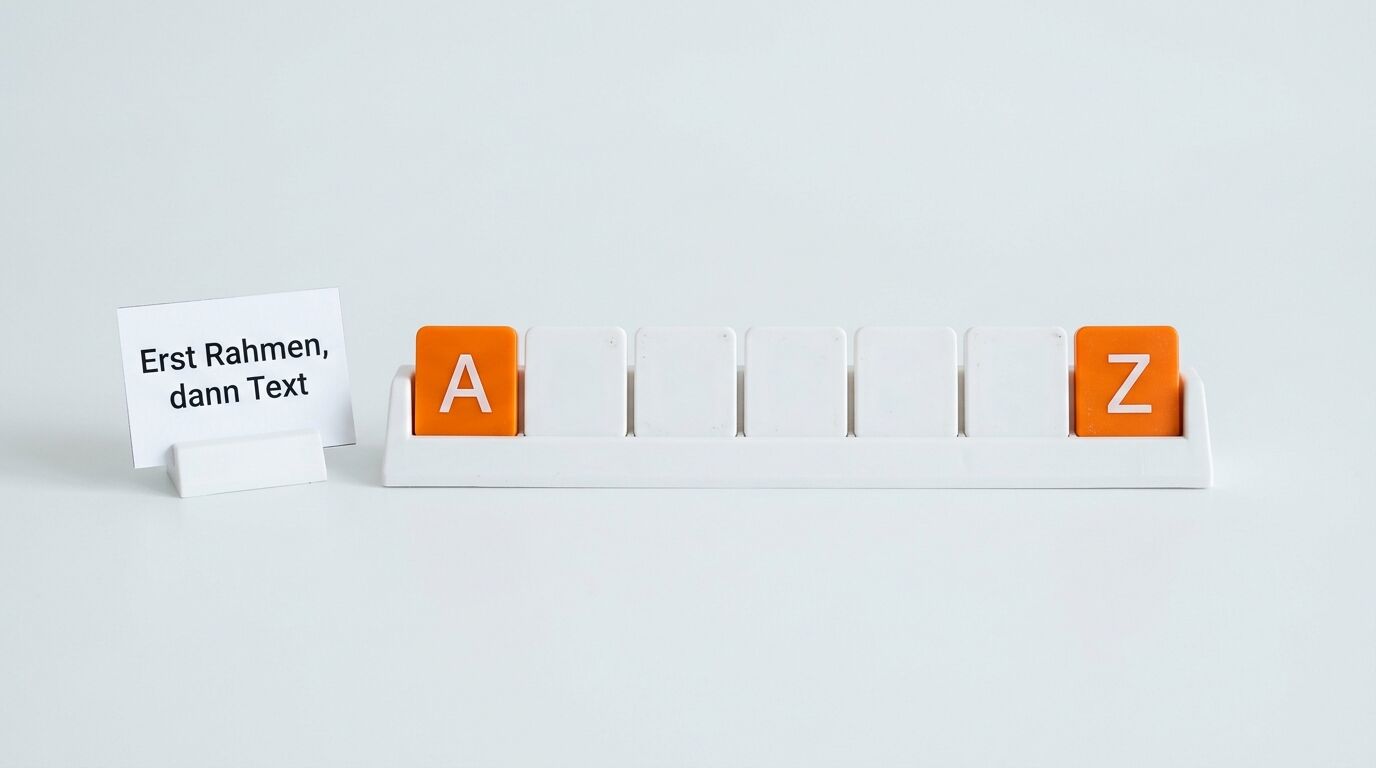
Autoregressive Modelle wie GPT, Claude oder Qwen sagen stets das nächste Token voraus. Jedes neue Wort hängt am vorigen. Ein früher Fehler bleibt stehen, die Antwortzeit wächst mit der Textlänge. Ein Diffusionsmodell startet dagegen mit einer Folge maskierter Platzhalter und rekonstruiert alle Positionen parallel.
Nach Angaben von DiffuSpace kann das Modell jede Stelle nachträglich überarbeiten und liest dabei an jeder Position den gesamten Kontext.[1] Weil pro Durchgang mehrere Token entstehen, verspricht das Start-up in bestimmten Szenarien fünf- bis zehnfaches Tempo. Unabhängige Messungen fehlen noch.
Technische Basis ist Dream 7B. Das NLP-Labor der Universität Hongkong veröffentlichte das Modell 2025 gemeinsam mit Huaweis Noah’s Ark Lab. Laut Fachaufsatz übertrifft Dream 7B frühere Diffusionsmodelle bei allgemeinen, mathematischen und Programmieraufgaben.[2] Kong Lingpeng, Gong Shansan und Ye Jiacheng aus diesem Labor gründeten DiffuSpace im Mai 2026.
Warum steigen Huawei und Horizon Robotics ein?
Für Huawei setzt die Beteiligung die Dream-Kooperation fort. Laut TMTPost forscht der Konzern zudem an einem Diffusionsmodell auf Basis seiner Pangu-Modelle für KI-Agenten.[1] Zwischen DiffuSpace und Horizon Robotics besteht dem Bericht zufolge keine strategische Partnerschaft. Der Chiphersteller nutzt Diffusionsmodelle aber bereits in der Planung automatisierter Fahrfunktionen und liefert seine Chips inzwischen auch an Bosch für Fahrassistenzsysteme in Europa.
Auf Fahrzeugchips, Laptops und Smartphones fehlt die Rechenleistung großer Rechenzentren, deshalb entscheidet dort das Tempo über die Nutzbarkeit. Die Finanzierung passt ins Bild: Chinas KI-Ausbau verschiebt sich vom Training zur Inferenz.
Im Westen gilt der Ansatz ebenfalls nicht mehr als Exot. Google DeepMind zeigt mit Gemini Diffusion eine experimentelle Demo, die im Schnitt 1.479 Token pro Sekunde erzeugt.[3] Das US-Start-up Inception Labs sammelte im November 2025 50 Millionen US-Dollar ein, umgerechnet knapp 45 Millionen Euro. Auch ByteDance, Nvidia und Google forschen laut Gong an solchen Modellen.
Huawei und Horizon sichern sich eine Option auf schnelle KI, die ohne Rechenzentrum im Auto und auf dem Laptop läuft. Europa diskutiert noch, China finanziert schon.
Markus Seyfferth, Chefredakteur Dr. Web


Zwei Wege, Text zu erzeugen
Was bedeutet das für Unternehmen im DACH-Raum?
Schnelle kleine Modelle machen On-Device-KI praktikabler: Die Kundendaten bleiben auf dem Gerät. Unter der DSGVO entfallen damit viele Fragen zur Auftragsverarbeitung und zum Datentransfer in Drittländer, die jede Cloud-KI aufwirft. Lokale KI-Modelle sind 2026 alltagstauglich geworden. Auch chinesische Anbieter wie iFlytek veröffentlichen eigene quelloffene On-Device-Modelle.
IT-Verantwortliche sollten bei Ausschreibungen neben der Modellgröße die Token pro Sekunde auf der eigenen Zielhardware messen lassen. Das offene Dream 7B eignet sich für einen ersten Test. In den USA gibt es keine staatliche Prüfung chinesischer Open-Weight-Modelle, das Weiße Haus verzichtet ausdrücklich darauf. Den Sicherheitstest übernimmt also der Anwender. Weitere Entwicklungen verfolgen Sie in unserer KI-Rubrik.
Quellen
[3] Google DeepMind: „Gemini Diffusion“, Modellseite
Mehr Newshunger?
- Zhipus KI baut ihr Inferenzsystem selbst um: 3,2-facher Durchsatz in zwei Wochen
- Joe Tsai: Alibaba-Chef sieht in offener KI Europas Weg zur Unabhängigkeit
- DeepSeek V4.1 Flash läuft ab Tag eins auf Chinas eigenen KI-Chips
- Kimi K3 in OpenAI Codex: Firmen bezahlen Chinas KI aus ihrem OpenAI-Budget
- Bonsai 27B: Ein Modell der 27B-Klasse, das auf dem Smartphone läuft
- MiniMax veröffentlicht seinen Terminal-Coding-Agenten als Open Source