DeepSeek-Gründer Liang Wenfeng nennt das Vorhaben die größte Wette seines Unternehmens. Das nächste Modell mit zwei Billionen Parametern soll auf Huaweis Ascend-Chips trainieren statt auf Nvidia. Genau dieser Umstieg scheiterte 2025 schon einmal und verlangt diesmal viermal so viele Beschleuniger wie bei Nvidia.
 drweb.de als bevorzugte Quelle auf Google hinzufügenQualitätsgeprüfte Inhalte direkt in Google News & DiscoverJetzt hinzufügen
Zwei Billionen Parameter, trainiert auf chinesischen Chips: Mit dieser Ansage hat DeepSeek-Gründer Liang Wenfeng Investoren auf den nächsten Modellsprung eingeschworen. Das KI-Training auf Huawei-Beschleunigern gilt ihm laut dem US-Branchendienst The Information als Priorität, obwohl das Unternehmen bis heute auf Nvidia rechnet.
Das Wichtigste in Kürze
- DeepSeek will seine nächste Modellgeneration erstmals vollständig auf heimischen Huawei-Chips trainieren, bislang lief das Training auf Nvidia.
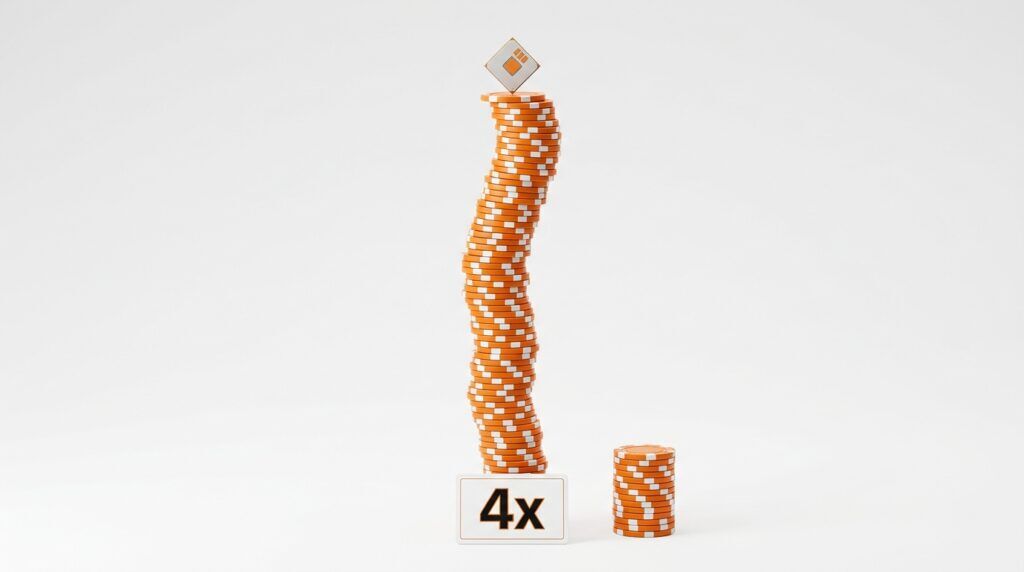
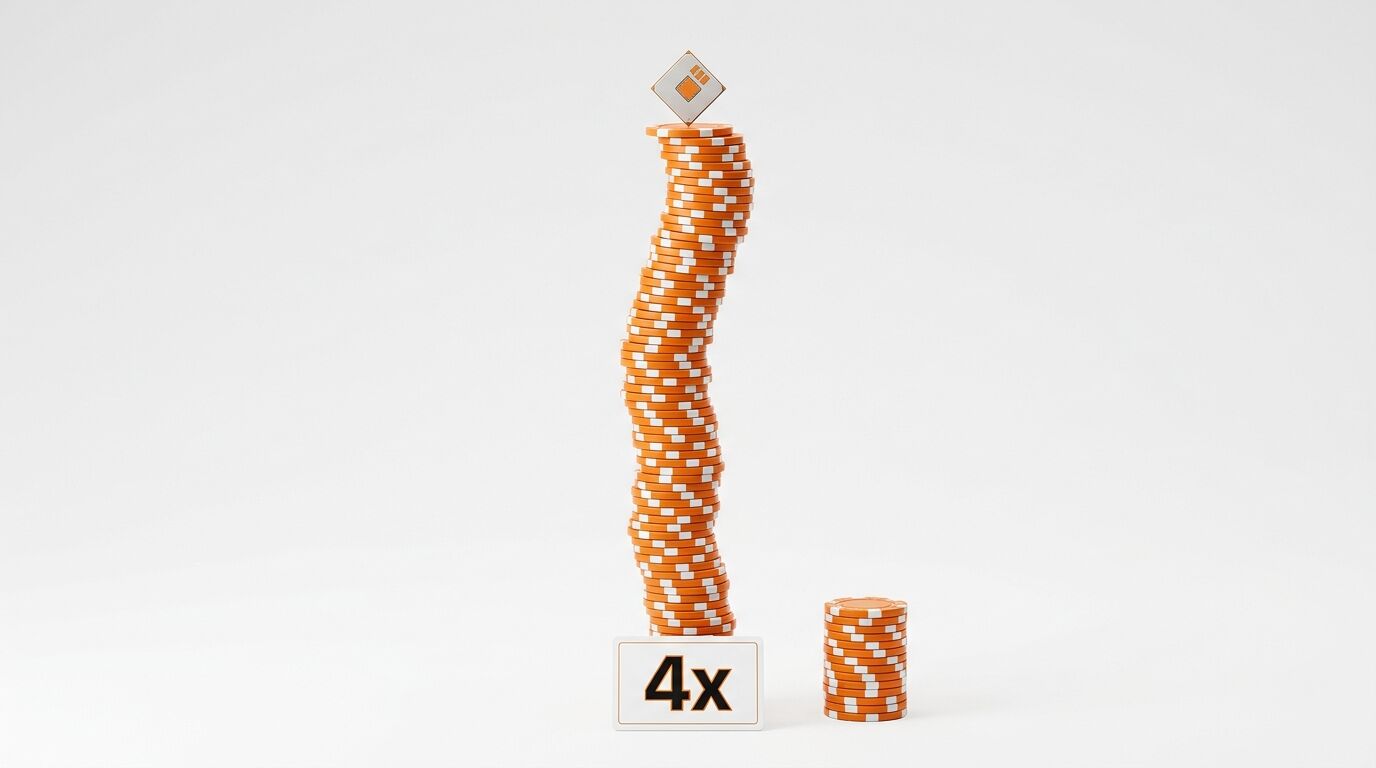
- Für ein Spitzenmodell veranschlagt Liang Wenfeng rund 200.000 Huawei Ascend 950 gegenüber 50.000 Nvidia GB300, ein Verhältnis von vier zu eins.
- Huaweis Ascend-950-Generation kommt laut Fahrplan ab dem vierten Quartal 2026, die Auslieferung an DeepSeek frühestens dann.
- Ein erster Trainingsversuch auf Huawei-Hardware scheiterte 2025 an instabiler Leistung und unreifer Software.
Warum wagt DeepSeek den Umstieg ausgerechnet jetzt?
Exportkontrollen zwingen zum Umbau. Washington hält Nvidias stärkste Beschleuniger von China fern. Peking treibt zugleich die heimische Chip-Versorgung voran, während Nvidia im China-Geschäft an Boden verliert. Die neue Ascend-950-Generation samt SuperPoD soll ab dem vierten Quartal 2026 bereitstehen.[1] Dass Chinas KI-Modelle schon bei der Inferenz auf heimischer Hardware laufen, führt DeepSeek mit seinem Flash-Modell vor.
Was kostet das Training auf heimischer Hardware?
Vier zu eins lautet die Rechnung. Für ein Modell auf dem Niveau der größten westlichen Systeme veranschlagt Liang Wenfeng laut The Information rund 200.000 Huawei Ascend 950, wo 50.000 Nvidia GB300 genügen. Mehr Chips bedeuten mehr Strom und mehr Fläche, die Kosten für denselben Trainingslauf steigen entsprechend. Schon der geplante Nachfolger soll auf acht Billionen Parameter wachsen.
Was der Umstieg vom Nvidia- auf das heimische KI-Training bedeutet
Ein Trainingslauf auf viermal so vielen Chips ist kein technisches Detail, sondern die eigentliche Rechnung der Chip-Souveränität. DeepSeek zeigt, dass Unabhängigkeit von Nvidia machbar wird, aber teuer erkauft ist.
— Michael Dobler, Herausgeber Dr. Web
Was bedeutet der Bruch mit Nvidia für Europa?
Zwei Ökosysteme driften auseinander. Gelingt DeepSeek das Training auf rein heimischem Silizium, entkoppelt sich Chinas KI-Branche weiter vom westlichen Stack. Günstige Modelle aus Fernost werden damit unabhängiger von US-Technik. Für Unternehmen im DACH-Raum verschärft der Umstieg die Debatte um digitale Souveränität und um den Energiehunger von KI, denn die vierfache Chipzahl treibt auch den Stromverbrauch. Ein Selbstläufer ist der Wechsel nicht: 2025 scheiterte ein erster Trainingsversuch auf Ascend-Hardware an instabiler Leistung und unreifer Software, weshalb DeepSeek zu Nvidia zurückkehrte. Andere chinesische Anbieter wie Zhipu verfolgen denselben Kurs, mit gemischter Bilanz.
Für den Einsatz chinesischer KI-Modelle wird die Hardware-Frage zur Pflichtprüfung: Trainingsbasis, Lieferketten und Datenschutz hängen zunehmend daran, welcher Chip unter dem Modell rechnet.
Quelle
[1] Huawei: „Huawei Unveiled the Latest SuperPoD, Making an AI Infrastructure New Option to the World“
Mehr Newshunger?
- 160.000 Huawei-Chips: DeepSeek baut sein Rechenzentrum ohne Nvidia
- Licht statt Stecker: Huawei bündelt 4.096 KI-Chips zum Supernode
- iFlytek Spark X2.5: Chinas neues KI-Modell verzichtet auf Nvidia
- SMIC verdoppelt den Gewinn: Chinas größte Chipfabrik lebt vom KI-Hunger
- Alibabas KI-Chip Zhenwu V900: 20 Gigawatt Rechenzentren bis 2032