Nvidia öffnet die GPU-Programmierung erstmals nativ für Rust und legt dafür zwei Werkzeuge vor: cuda-oxide und cutile-rs. Der eigentliche Gewinn liegt nicht in der Sprache, sondern im Zeitpunkt, zu dem Speicherfehler auffliegen. Für Teams, die KI-Kernel schreiben, verschiebt CUDA Rust die Fehlersuche vom Absturz zur Kompilierung.
 drweb.de als bevorzugte Quelle auf Google hinzufügenQualitätsgeprüfte Inhalte direkt in Google News & DiscoverJetzt hinzufügen
Ein GPU-Kernel, der seinen eigenen Ausgabepuffer versehentlich auch als Eingabe bekommt, kompiliert unter CUDA Rust nicht mehr. Genau solche Aliasing-Fehler kosten CUDA-C++-Entwickler bisher Stunden im Debugger, weil die Fehler erst zur Laufzeit auffallen, oft als still verfälschtes Ergebnis. Nvidia verkauft die Rust-Anbindung deshalb nicht als Sprachkosmetik, sondern als Angriff auf eine ganze Fehlerklasse.
Das Wichtigste in Kürze
- Nvidia bietet zwei Wege für GPU-Kernel in Rust: cuda-oxide für den klassischen SIMT-Stil und cutile-rs für Tile-basierte Kernel.
- Beide nutzen Rusts Eigentumsmodell und fangen doppelt genutzte Speicherpuffer schon beim Kompilieren ab.
- cutile-rs läuft auf stabilem Rust 1.89 und steckt bereits in Hugging Faces Inferenz-Engine Grout und in mistral.rs.
- Der Lock-in bleibt: Die Kernel übersetzen weiter nach PTX und laufen nur auf Nvidia-Hardware.
Was steckt hinter CUDA Rust?
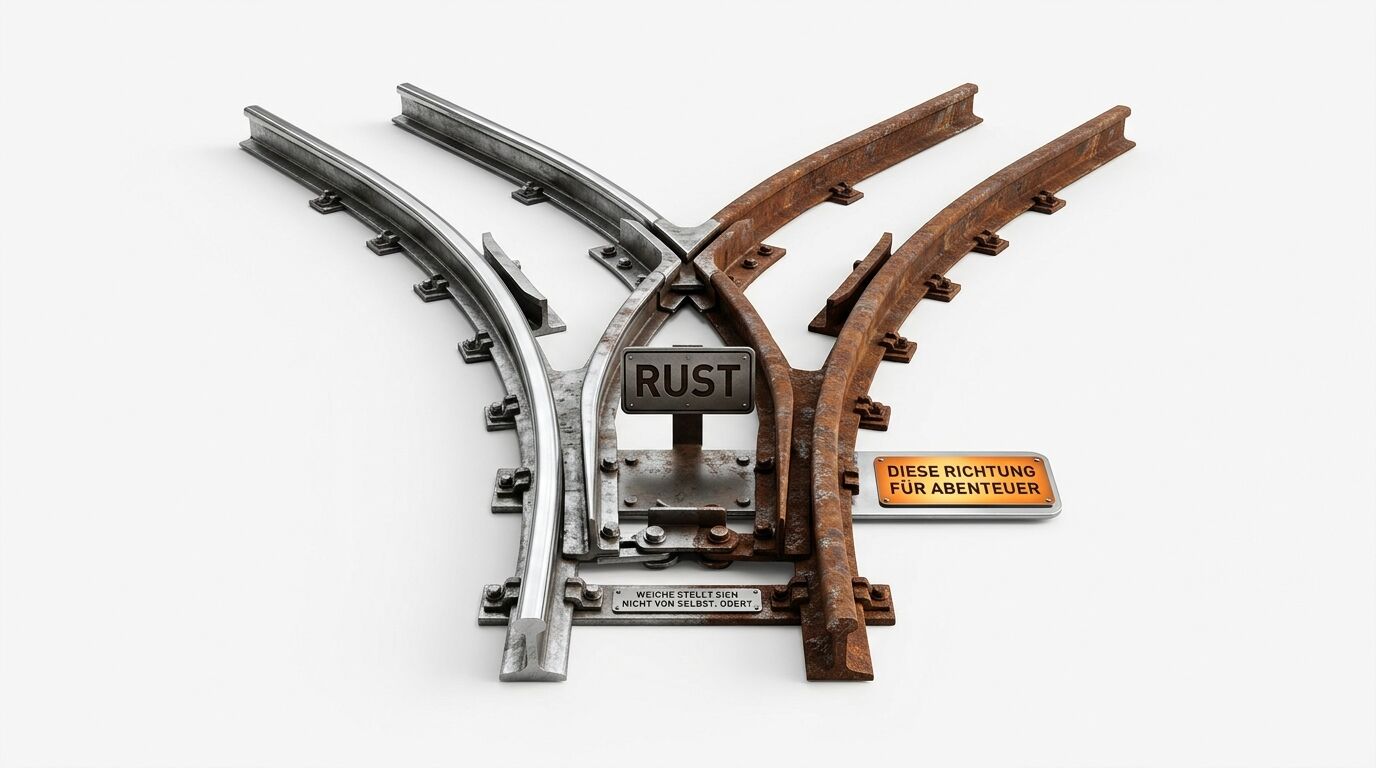
Nvidia trennt die Rust-Anbindung für KI-Kernel in zwei Spuren. cuda-oxide zielt auf den vertrauten SIMT-Stil und schleust als eigenes rustc-Backend die Kernel über Rust MIR, die Pliron-IR und LLVM bis nach PTX. Der Weg verlangt eine festgepinnte Rust-Nightly, CUDA 12.x und Linux und steht als frühe Alpha.[1]
Die zweite Spur, cutile-rs, kompiliert Tile-basierte Kernel beim ersten Start über die CUDA Tile IR. Der Weg läuft auf stabilem Rust 1.89, liegt auf crates.io und wird laut Nvidia bereits in der Inferenz-Engine Grout von Hugging Face und in mistral.rs genutzt.[1] Dass ausgerechnet der von Nvidia übernommene KI-Hub Hugging Face cutile-rs produktiv einsetzt, macht aus der Ankündigung eine belegte Praxis.
Warum fängt Rust GPU-Fehler früher ab?
Der Kern liegt in Rusts Eigentumsmodell. Ein eigener Slice-Typ erlaubt jedem Puffer nur einen schreibenden Zugriff, und der Compiler weist Verstöße ab. Übergibt ein Kernel seinen Ausgabepuffer zugleich als Eingabe, verweigert der Compiler die Übersetzung, auf beiden Spuren gleich.[1]
In CUDA C++ kompiliert dieselbe Verwechslung anstandslos und verfälscht das Ergebnis still, ein Fehler, der sich im Rechenzentrum erst nach dem Deployment zeigt. Speichersicherheit auf der GPU reiht sich damit in eine größere Bewegung ein: Erst machte Microsoft Rust zur Tier-1-Sprache, dann stellte Ubuntu seine Coreutils auf Rust um. Sicherheitsbehörden drängen seit Jahren auf speichersichere Sprachen, jetzt erreicht der Ansatz die Recheneinheit selbst.
Rust auf der GPU löst nicht das Lock-in, sondern das teurere Problem: Speicherfehler, die im Rechenzentrum erst nach dem Deployment auffallen. Für neue KI-Kernel ist cutile-rs schon jetzt die vernünftigere Wahl, für die Produktionslast der Prüfstein.
— Markus Seyfferth, Chefredakteur Dr. Web
Was heißt das für deutsche KI-Teams?
Einen Ausweg aus der Nvidia-Bindung liefert CUDA Rust nicht. Die Kernel enden weiter als PTX und laufen nur auf Nvidia-GPUs, dieselbe Abhängigkeit, die gerade ein französisches Kartellverfahren beschäftigt. Rust wechselt den Programmierkomfort, nicht die Plattform.
Für die Praxis zählt der Reifegrad. cutile-rs ist stabil und produktionsnah und eignet sich schon heute für neue Kernel; cuda-oxide bleibt als Nightly-Alpha ein Fall fürs Labor. Belastbare Benchmarks legt Nvidia bisher nicht vor, ein Grund, bestehende C++-Kernel noch nicht umzuschreiben.
In der Praxis heißt das: neue Kernel testweise in cutile-rs aufsetzen und die Produktionslast bei CUDA C++ belassen, bis Nvidia Zahlen liefert. Parallel lohnt der Aufbau von Rust-Kompetenz im Team, bevor Speichersicherheit im Rechenzentrum vom Wettbewerbsvorteil zur Ausschreibungsbedingung wird.
Nvidias zwei Wege zu speichersicheren GPU-Kerneln


Die zwei Wege im Vergleich
cuda-oxide (SIMT)
Eigenes rustc-Backend, kompiliert nach PTX. Braucht Rust-Nightly vom 3. April 2026, CUDA 12.x und Linux. Status: frühe Alpha.
cutile-rs (Tile)
JIT über die CUDA Tile IR. Läuft auf stabilem Rust 1.89, CUDA 13.3, liegt auf crates.io und steckt in Hugging Faces Grout und mistral.rs.
Quelle
[1] Nvidia Technical Blog: „Introducing CUDA Rust: Two Tracks for Writing GPU Kernels“
Mehr Newshunger?
- Microsoft macht Rust zur Tier-1-Sprache
- Ubuntu 26.10 vollendet den Umstieg auf Rust-basierte Coreutils
- Nvidia und die CUDA-Falle: Frankreichs Kartellverfahren steht vor dem Abschluss
- Streit um KI-Sicherheit: Anthropic will eine Kartellausnahme, Nvidia lehnt ab
- Loongson 9A1000: Chinas erste eigene GPU wird auch zur KI-Karte
- Nvidia kauft Hugging Face: 11,25 Milliarden Euro für den offenen KI-Hub